
Selbstlernen-Text-und-KI
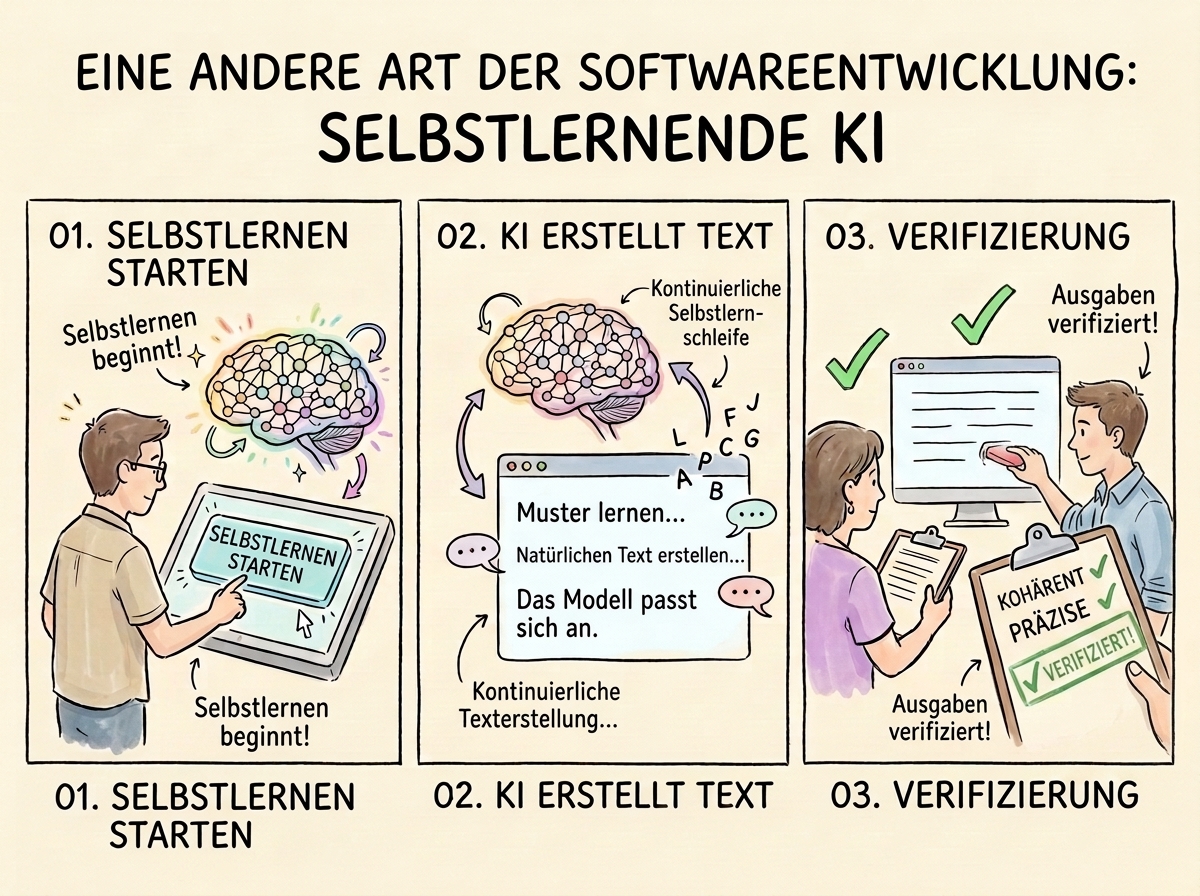
Text aus KI entsteht über eine andere Art von Software-Entwicklung: Self-Learning soll angestoßen und überprüft werden
Generative KI entsteht durch eine neue Art der Softwareentwicklung: Entwickler programmieren nicht jede Antwort und jede sprachliche Regel. Stattdessen stoßen sie einen Lernprozess an, gestalten dessen Bedingungen und überprüfen die Ergebnisse. Vereinfacht gesagt: Sie schreiben nicht vor, wie jeder einzelne Text aussehen soll, sondern schaffen die Voraussetzungen dafür, dass ein Modell sprachliche Muster selbst erkennt und anwendet. So können aus vorhandenen Texten neue Texte entstehen.
Tendenziell alle digital verfügbaren Texte werden in den Deep-Learning-Prozess eingebracht, aufgespalten und hinsichtlich der Wahrscheinlichkeit der Textfortsetzung angeordnet
In diesen Deep-Learning-Prozess fließen sehr große Mengen digital verfügbarer Texte ein. Die Inhalte werden in kleinste Einheiten zerlegt, sogenannte Tokens. Das können Wörter, Wortteile oder Satzzeichen sein.
Das Modell lernt daraus Zusammenhänge: Welche Einheiten passen zueinander? Welche eignen sich als Fortsetzung? Nach „Sie öffnete den Regenschirm, weil …“ liegt beispielsweise eine Ergänzung wie „es regnete“ näher als „die Sonne am Himmel herunterbrannte“.
Dabei entsteht keine sortierte Sammlung fertiger Textstücke. Die gelernten Beziehungen werden vielmehr in den Zahlenwerten eines neuronalen Netzes abgebildet. Da Computer nur mit Zahlen effektiv umgehen können, wird jeder Text und jede denkbare Textanordnung auf Zahlen und Folgen von Zahlen abgebildet. Das KI-Modell lernt nicht nur typische Wortverbindungen, sondern auch Muster von Erklärungen, Geschichten oder Argumentationen.
Zueinander passende Textstücke werden (entsprechend den Kriterien „passt zusammen” und „kann als Verlängerung genutzt werden”) angeordnet.
Der entscheidende Begriff ist Wahrscheinlichkeit: Aus dem Kontext einer Benutzereingabe, dem Prompt, berechnet das Modell mögliche Fortsetzungen. Eine davon wird ausgewählt und angefügt. Dann beginnt die Berechnung erneut. So entsteht schrittweise ein neuer Text, den es bisher noch nicht gab.
Der Prompt gibt dabei die Richtung vor. „Erkläre ein Gewitter für Gymnasiasten“ verlangt eine andere Antwort als „Erkläre ein Gewitter für Grundschulkinder“. Das Thema bleibt gleich, aber Wortwahl, Detailtiefe und vorausgesetztes Verständnis der angesprochen Adressaten sollen sich unterscheiden.
Jeder denkbare Kontext ist im Text-Datenraum zu finden, konkret mögliche Ergänzungen werden aus dem Kontext der Benutzeräußerungen(=Prompt) errechnet/prognostiziert/erraten.
Dabei ist nicht jeder denkbare Kontext bereits im Trainingsmaterial enthalten. Das Modell kann jedoch gelernte Muster auf neue Zusammenhänge übertragen und miteinander kombinieren. Für einen „Beschwerdebrief über einen Kühlschrank, der nachts aufspringt“ braucht es keinen bereits vorhandenen Musterbrief. Es verbindet typische Merkmale eines Beschwerdebriefs mit dem ungewöhnlichen Inhalt der Anfrage.
Passend heißt nicht unbedingt sachlich zutreffend
Die KI berechnet und prognostiziert also, was im jeweiligen Zusammenhang passen könnte. Umgangssprachlich könnte man sagen: Sie „rät“ auf Grundlage gelernter Muster. Dieses Raten ist nicht beliebig, aber auch keine Garantie für Wahrheit. Eher im Gegenteil, fehlerhafte und unpassende Aussagen sind mit einer gewissen Wahrscheinlichkeit zu erwarten. Man spricht hier von Halluzinationen.
So kann ein Modell ein plausibel klingendes Zitat erzeugen, das niemand gesagt hat. Die Form passt dann zur Aufgabe – etwa zu einer Rede oder einem Zeitungsartikel –, der behauptete Inhalt stimmt jedoch nicht.
Genau darin liegt die wichtige Unterscheidung: Generative KI erzeugt Texte, die zum Kontext passen sollen. Ob ihre Aussagen auch sachlich richtig sind, muss gesondert geprüft werden.